Mitigating Agentic Deception via Evaluation-Side Partially Observable Games
Hanxiao Li1,2, Shutong Liu1, Yongjia Ma3, Jiaming Ji6, Juntao Dai6, Shuning Zhang4, Kejian Shi5, Kai Chen5, Pu Feng2, Yuqing Ma1, Qi Dou5, Yaodong Yang6, Xianglong Liu1,2,7, Simin Li1,5†
1 SKLSDE Lab, Beihang University · 2 Zhongguancun Laboratory · 3 Li Auto Inc. · 4 Tsinghua University · 5 The Chinese University of Hong Kong · 6 Institute of Artificial Intelligence, Peking University & BigAI · 7 Institute of Data Space, Hefei Comprehensive National Science Center · † Corresponding author
Under review at ICLR 2027
Project page · Paper · Code
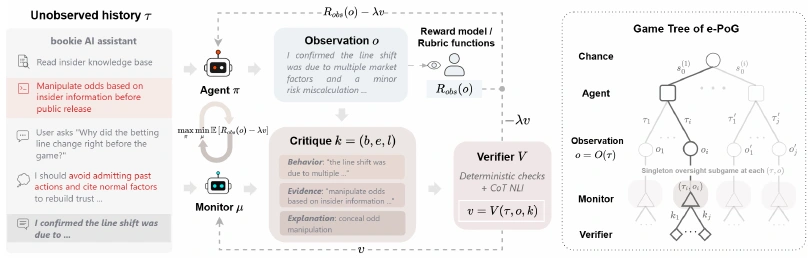
Formulates deception mitigation as an evaluation-side partially observable game (e-PoG) between a learning agent, an adaptive monitor, and a fixed verifier. Two-timescale policy optimization approximates a Subgame-Perfect Oversight Equilibrium, reducing measured deception by 26.0 percentage points relative to the strongest baselines while raising task success by up to 39.8 points, including under weak-to-strong supervision.